Objekte lokalisieren und gleichzeitig klassifizieren
Für Zähl- und Vollständigkeitsprüfungen müssen einzelne Objekte zuverlässig erkannt, lokalisiert und klassifiziert werden. Eine intuitiv bedienbare Trainingsumgebung macht diese anspruchsvolle Form der Bildverarbeitung auch ohne tiefgehende KI-Kenntnisse zugänglich.
Sandra Pliewischkies, Content Manager bei Wenglor
Die Objekterkennung zählt zu den anspruchsvolleren Aufgaben der industriellen Bildverarbeitung. Im Unterschied zur reinen Klassifikation müssen einzelne Objekte in einem Bild lokalisiert und gleichzeitig einer Klasse zugeordnet werden. Für Anwendende mit wenig KI-Erfahrung war dies bislang häufig mit einem hohen Einarbeitungsaufwand verbunden. Genau hier setzt wenglor mit der Objekterkennung im AI Lab an: Ein Jahr nach dem Launch erweitert das Unternehmen die cloudbasierte Plattform um eine Funktion, mit der sich komplexe Zählaufgaben lösen lassen, ohne dass tiefgehendes KI-Fachwissen erforderlich ist.
Von der Klassifikation zur Objekterkennung
Das AI Lab unterstützte bisher nur die Multi-Class- und Multi-Label-Klassifikation. Bei der Multi-Class-Klassifikation wird ein Bild genau einer Klasse zugewiesen, beispielsweise „vollständig“ oder „unvollständig“. Die Multi-Label-Klassifikation ermöglicht es, einem Bild mehrere Klassen zuzuordnen. Beide Verfahren treffen jedoch keine Aussage darüber, wo sich ein bestimmtes Objekt befindet oder wie häufig es im Bild vorkommt. Diese räumliche Information ergänzt die Objekterkennung: Relevante Objekte werden lokalisiert, beim Annotieren mit Begrenzungsrahmen (sogenannten Bounding Boxes) gekennzeichnet und einer Klasse zugewiesen. So erlernt das Modell die Objektklasse und deren Position im Bild. Die Objekterkennung eignet sich damit unter anderem für Anwesenheits-, Zähl- und Vollständigkeitsprüfungen.
Einfache Bedienung trotz höherer Komplexität
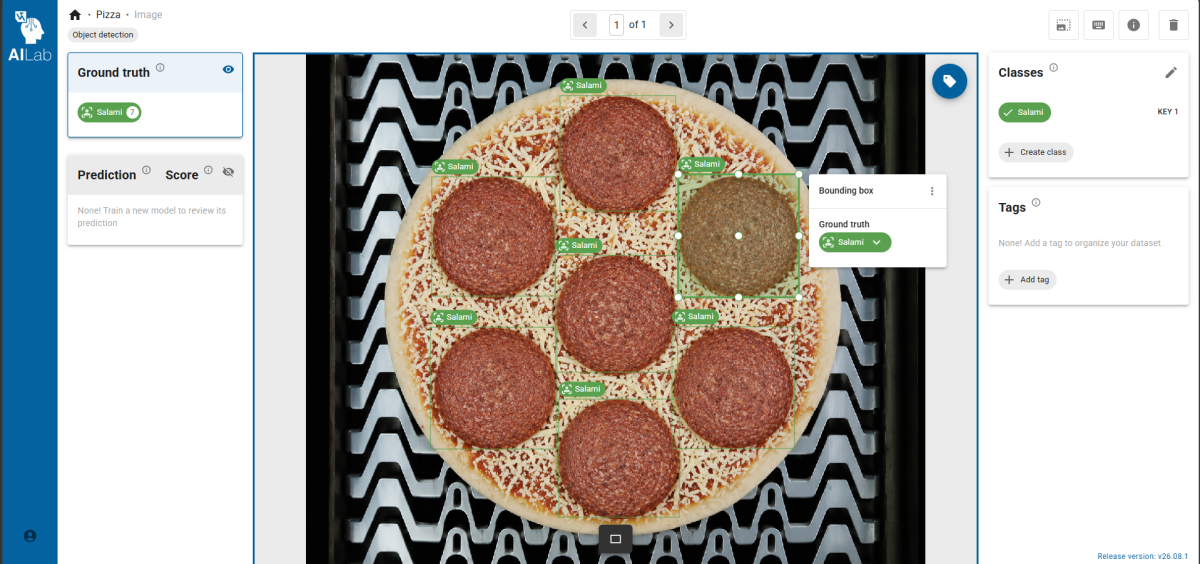
Für die Objekterkennung wurde das Labeling-Tool um Bounding Boxes erweitert. Anwendende ziehen einen Begrenzungsrahmen um jedes relevante Objekt und ordnen ihm eine Klasse zu. Bei einer Tiefkühlpizza wird beispielsweise um jede einzelne Salamischeibe ein Rahmen gezogen und der Klasse „Salami“ zugeordnet. Die Pizza selbst erhält in diesem Anwendungsfall keine eigene Box. Obwohl die Objekterkennung zusätzliche Arbeitsschritte erfordert, orientiert sich die erweiterte Benutzeroberfläche an den bereits bekannten Bedienmustern des AI Labs. Dadurch können auch Personen ohne Erfahrung mit vergleichbaren Werkzeugen schnell in das Labeling einsteigen. Die erzeugten Ground-Truth-Daten enthalten für jedes markierte Objekt die Klasse und seine Position im Bild und dienen dem Modell während des Trainings als Referenz.
Der Ablauf bleibt nah an den bereits verfügbaren Klassifikationsfunktionen: Zunächst werden Klassen definiert und anschließend die Objekte in den Trainingsbildern markiert. Darauf folgen das Training und die Überprüfung der Ergebnisse. Der zusätzliche Aufwand entsteht vor allem durch die objektgenaue Annotation: Befinden sich sieben Salamischeiben in einem Bild, müssen alle Instanzen nach denselben Regeln erfasst werden. Uneinheitlich gesetzte Rahmen können widersprüchliche Trainingsinformationen erzeugen.
Unkomplizierter Einstieg, verlässliche Ergebnisse
Bei der Entwicklung stand ein zentrales Anliegen im Vordergrund: Die Objekterkennung soll auch für Anwendende zugänglich sein, die bislang mit einfachen Edge-Geräten arbeiten und wenig Erfahrung mit komplexeren KI-Werkzeugen haben. Diese Zielgruppe soll sich nicht zunächst aufwendig in ein kompliziertes Tool einarbeiten müssen. Stattdessen soll die Objekterkennung im AI Lab genauso schnell nutzbar sein wie die bereits etablierten Funktionen. Die einfache Bedienung darf dabei jedoch nicht zulasten der Ergebnisqualität gehen. Werden Modelle mit zu wenigen Bildern trainiert oder die Trainingsdaten nur oberflächlich gelabelt, können sie mit wechselnden Umgebungsbedingungen häufig nur unzureichend umgehen. Beim AI Lab wurde deshalb gezielt darauf geachtet, dass trotz der einfachen Bedienbarkeit stabile und robuste Modelle entstehen, die auch unter realen, wechselnden Produktionsbedingungen zuverlässig funktionieren. Der Einstieg gelingt dadurch schnell, und erste belastbare Ergebnisse liegen oft schon nach kurzer Zeit vor.
Datenqualität entscheidet über die Modellleistung
Die Bedienoberfläche erleichtert das Erstellen der Annotationen, ersetzt jedoch nicht die fachliche Bewertung der Daten durch den Anwendenden. Um ein belastbares Modell zu erhalten, sollten die Trainingsbilder die Bedingungen der späteren Anwendung so realistisch wie möglich darstellen. Dazu gehören etwa unterschiedliche Positionen, Beleuchtungssituationen, Hintergründe, zulässige Bauteilvarianten und typische Fehlerbilder. Auch teilweise verdeckte oder reflektierende Objekte können relevant sein. Werden solche Varianten nicht berücksichtigt oder Bounding Boxes inkonsistent gesetzt, kann die Modellleistung im realen Betrieb deutlich hinter den Ergebnissen aus dem Trainingsdatensatz zurückbleiben.
Ebenso wichtig ist eine saubere Trennung von Training, Validierung und abschließendem Test. Ergebnisse auf Bildern, die bereits für das Training verwendet wurden, erlauben keine belastbare Aussage über die spätere Anwendung. Aussagekräftiger ist ein unabhängiger Testsatz, der die erwartete Varianz abdeckt.
Training in der Cloud, Ausführung auf dem Gerät
Annotation, Training und Validierung finden im AI Lab in der Cloud statt. Dadurch ist für das rechenintensive Modelltraining keine eigene lokale Trainingsinfrastruktur erforderlich. Nach Abschluss des Trainings wird das Modell über Wehub in Univision übertragen und auf der Smartkamera B60 oder einem Machine Vision Controller der MVC-Serie ausgeführt. Im laufenden Betrieb erfolgt die Auswertung lokal; eine dauerhafte Verbindung zum AI Lab oder zum Internet ist dafür nicht notwendig.
Praxisbeispiel: Vollständigkeitsprüfung an einer Tiefkühlpizza
Wie sich die zusätzliche Ortsinformation nutzen lässt, verdeutlicht die Vollständigkeitsprüfung einer Tiefkühlpizza. Im Sollzustand befinden sich sieben Salamischeiben an den vorgesehenen Positionen auf der Pizza. Für das Training wird jede sichtbare Salamischeibe im Labeling-Tool als eigene Instanz annotiert. Im laufenden Betrieb nimmt die Smartkamera die Pizza auf. Das lokal ausgeführte Modell erkennt die Salamischeiben, ordnet sie der entsprechenden Klasse zu und lokalisiert sie mithilfe von Bounding Boxes. Aus den Erkennungsergebnissen kann die Prüfapplikation anschließend die Anzahl der Salamischeiben ermitteln und ihre Positionen mit definierten Prüfbereichen vergleichen.
In einem Fehlerfall ermittelt das System beispielsweise sechs statt der vorgesehenen sieben Salamischeiben und verknüpft damit das Kamerabild unmittelbar mit einem numerischen Ergebnis. Für eine Qualitätskontrolle genügt die reine Anzahl allerdings nicht in jedem Fall. Sollen auch falsch positionierte Salamischeiben erkannt werden, müssen die Objektkoordinaten mit den zulässigen Bereichen verglichen werden. Eine Orientierung oder Drehlage wird durch eine gewöhnliche Bounding Box nicht automatisch bestimmt.
Vom Modell zur belastbaren Prüfentscheidung
Die Objekterkennung erweitert das AI Lab um Anwendungen, bei denen Anzahl und Position einzelner Objekte entscheidend sind. Der durchgängige Workflow verbindet Datenverwaltung und Modelltraining in der Cloud mit der lokalen Ausführung in der Produktionsumgebung, wodurch die technische Einstiegshürde sinkt. Die Verantwortung für konsistente Annotationen und eine anwendungsbezogene Validierung bleibt jedoch bestehen. Für den Serieneinsatz sollten typische Gutteile und Schlechtteile sowie relevante Grenzfälle mithilfe unabhängiger Testdaten geprüft werden.